Effective Debug Logging (part 2)

2007年7月22日 没有评论

这是这个系列文章的第二部分,我们将关注如何过滤调试日志的问题,亦即索引当中“调试日志的分级和分类:提高日志的信噪比”一项。

调试日志的分级和分类

调试日志的分级和分类的目的在于能够更好的对大量的日志进行过滤,使得可以容易地从某个或某些方面分析日志。

日志的分级是已经广为接受的一种做法,例如Windows的事件日志就分为错误、警告、信息三种级别,而内核的DbgPrintEx函数也包含有日志分级的参数,并且给出了四种预设的级别。为调试日志实现分级的主要目的是过滤不必要的消息,以便能够让重要的调试信息不会淹没在大量的无用信息当中,同时在正常的使用过程当中,控制调试信息的输出也可以提高系统的效率。

在具有分级的调试日志实现当中,通常系统都会至少指定3种调试信息的级别,即错误、警告和信息。也有系统提供更加细致的级别,例如比错误更高级别的“致命错误”级别,或比信息级别更低的“调试”级别和“追踪”级别。通常情况下不同的级别使用一个正整数值来表示,一般的约定是使用较小的值表示优先级较高的调试信息,例如致命错误为0级,可恢复错误为1级等等。

通常具有调试日志分级的产品都会采用某种方式来指定需要打印的调试级别,这个可以通过命令行参数或者配置文件指定,通常接受一个正整数。在打印调试日志的地方,开发人员需要指定调试日志的级别,当这个级别高于或等于全局的调试级别时,这条调试日志便会输出。这种方式简单而且有效,因此得到了广泛的应用。

但是这里面隐含着一个实际当中需要面对的问题。虽然我们提供了不同的级别,四种或者五种,但是通常被用到的通常只有其中的两个极端的级别:在正常运行过程
当中,用户往往选择不打印任何的日志,或者只打印级别较高的日志;而当软件在客户处遇到了问题的时候,支持人员往往要求客户直接将调试日志级别调到最详细
的级别,然后搜集日志。因此,日志分级需要首要考虑的问题很多的时候并非为用户提供对于日志输出量的控制,而是为了开发人员拿到细致的日志的时候,能够快速的对其进行过滤,并在不同级别
上定位问题。因此调试级别不宜太多,分的过细没有太大的意义,而且容易使得在编写调试日志的时候难以确定正确的级别。我们比较倾向于五个级别:致命错误、可恢复错误、警告、信息、调试,有时候致命错误和可恢复错误不加区分,也就变成的四种级别。另外,应当在最终的日志文件当中记录每条日志的级别,以便于拿到日志之后可以根据级别过滤。

因此,我们有了Tip 3和Tip 4:

Tip 3:使用日志分级显示的机制,在正常运行当中控制日志的输出量,调试情况下输出尽可能细致。
Tip 4:在日志当中记录当前日志的级别,便于拿到日志之后的过滤和分析。

由于通常开发人员拿到的都是最详细的级别的调试日志,而在这个级别上面,各个模块通常都会打印出大量的日志,这种日志到了支持人员和开发人员手中之后,也往往由于数量巨大而难于处理和分析。因此如何可以更加细致的进行日志的分类,就是成了另一个需要解决的问题。

对于调试日志分类的设计有两个方面的考虑:一方面,对于日志分类倾向于尽可能的细致,以便拿到日志的开发人员能够在更加细致的级别上分析日志,另一方面,由于日志所从属的类别需要开发人员在写每一条日志的时候确定,因此,应该能够让开发人员能够快速的决定日志的类别,以便减少开发人员的工作,这就要求日志的分类不能过于细致。这两个方面相互矛盾,因此,设计良好分类方式,抛弃不必要的分类,使设计当中需要考虑的一个重要方面,否则开发人员花费在确定日志的类别上的时间比写代码的时间还多,就得不偿失了。

另外,由于调试日志的分类可以有几种不同的方式,例如基于模块进行分类,基于目的进行分类,等等,因此设计几个分类的维度也是一个需要仔细考虑的问题。因为开发人员在写日志的时候,需要考虑的问题目前至少有:什么级别,什么内容。我们每增加一个日志的分类维度,就使得开发人员增加了一个需要考虑的问题,这极大的增加了开发人员的工作,也可能是的开发人员因此开始不喜欢写调试日志,反而适得其反。因此,我们的经验是最多只添加一种分类的维度,这种通常就是基于模块的分类。

Tip 5:添加调试日志的工作越简单,开发人员越喜欢在代码当中添加调试日志。

基于模块的分类和过滤方案可以有多种方式实现。第一种是对于不同的模块使用不同的配置项控制其调试级别,之间互不影响。另一种使用全局的配置项控制调试级别,但是对于不同模块的日志文件使用不同的文件名前缀。例如按照第一部分的那种日志文件命名方案,使用不同的basename。第三种方案则使用类似于分级的方式实现,开发人员在代码当中加入调试日志的时候,指定一个模块的标识,而在程序运行的时候,通过某种方式如命令行和配置文件来指定需要显示的模块,来实现基于模块的过滤。

三种方案各有其优劣。

第一种方案的优势在于可以细致的控制各个模块的日志信息。这种在现场调试的时候比较有优势,但是在无法现场支持的时候就存在一定的操作难度。因为对于支持人员来说,往往倾向于拿到尽可能详细的日志,因此在搜集日志的时候,也往往要求用户将模块的调试级别都调到最详细。这样一来,一方面增加了用户的操作难度,另一方面对于最后分析日志的开发人员来说,这种方案并没有改变多少问题。因此,

Tip 6:即使需要对于每个模块分别控制日志级别,最好也能够提供一个全局的日志级别控制选项。

第二种方案则稍有改进,其优势在于便于搜集和浏览,因为每个文件都单纯的对应于一个模块,不存在模块之间互相穿插的问题,因此人阅读比较容易,也便于工具的处理。但是如果模块划分过细,会导致难于跟踪模块之间的互操作。比如模块A会在处理过程当中调用模块B,但是两者的日志分布在不同的日志文件当中,这样的结果往往是在察看日志的时候,需要在两个日志文件之间跳来跳去,反而使得分析变得麻烦。因此这种方案通常用在比较粗粒度的子系统级别。将不同子系统的日志输出到不同前缀的日志文件,可以在划分模块和便于分析之间找到一种折中。而且结合第一种方案,也可以对于不同的子系统提供不同的调试级别的控制。

Tip 7:在子系统级别上,让不同的子系统把日志输出到不同的日志文件

第三种方案则在第二种方案上面更进了一步,可以用来区分子系统当中不同的模块。这种方案当中对于模块标识的选择也有几种不同的设计。一种是使用短字符串作为模块的标识,例如main,server,client等字符串,而在配置文件当中,使用逗号或其他符号分割的字符串选择需要输出的模块。另一种方案是使用整数的位掩码(bit mask),每个模块对应于一个整数当中的一个位,而使用位AND操作来确定是否需要输出该模块的信息。表面看起来似乎前者更具有良好的可读性和可配置性,而后者则相对难于理解和配置。但实际当中,这种考虑应该放在相对较为次要的位置。因为用户对于模块的调试日志的控制往往也是两个极端:none或all,而如何让开发人员更加容易的添加调试日志,以及拿到所有模块都打开的日志的时候如何便于根据模块进行过滤和分析,才是设计调试日志方案的首要考虑。因此,我更倾向于使用第二种方案来实现,这样在最后的日志分析当中,更容易用脚本来进行辅助。与日志级别类似,在最终的日志文件当中,也应该记录该日志条目所从属的类别。

Tip 8:在子系统内部,对于不同的模块,使用不同的模块标识,便于开发人员进行分析和过滤。

实际当中,这三种方案放在一起实现是最为有效的。总结一下就是:提供一个全局的调试级别控制,在每个子系统上面提供一个该子系统的级别控制,该控制默认情况下使用全局控制,在特殊情况下可以覆盖全局控制;让不同子系统的日志输出到不同的日志文件当中;子系统内部的模块使用模块标识区分,并将其记录进最终的日志条目当中,便于开发人员使用人工或脚本过滤和区分。

如上Tip 5所述,我们希望添加的模块信息不会增加开发人员的工作,因此实现日志根据模块划分类别,可以采用了一些tricks来简化日志的添加工作。例如,每个源代码文件通常都只从属于一个模块,因此,我们可以在每个源代码文件的顶端添加它从属的模块的信息,而使用宏来自动的在每条日志当中添加模块信息。这样,开发人员其实并没有增加太多的工作要做。

而在实际当中,很多时候简单的根据日志从属的模块区分还不够,比如可能需要把所有的函数跟踪日志和路径跟踪日志作为两个单独的级别,这时也许我们就需要引入一些别的分类方式,但是即使有这种需求,我们也建议把他们并入到模块级别当中,因为任何一个增加的维度都是以增加开发人员的工作作为代价的。通常,我们建议使用宏来简化这些添加动作,而且,除非真的必要(很多时候这两种需求是可以由其他的日志代替的),我们不建议增加更多的日志分类方式。

Tip 9:使用一些tricks来简化调试日志的添加,减少开发人员在写调试日志时需要考虑的问题。

下面,我们开始探讨如何在正确的地方添加正确的日志,也就是“日志应该写些什么”的问题。

标签:

Effective Debug Logging (part 1)

2007年7月22日 没有评论

有感于当时在学校的时候做项目和进入公司之后参与产品开发的经历,深感产品支持的难度——客户的环境千差万别,因此可能出现的问题也千差万别,而且很多问题只有在客户的环境当中才可能重现,这个时候,如何快速的定位问题并给出解决方案,是一个非常重要的问题。

通常我们采用的都是调试日志,也就是Debug Logging的方法。在正常的情况下,调试日志并不会被打印出来,只有当出现问题时,通过适当的方式(配置文件或者命令行)将其打开,在客户环境当中重现,并将调试日志收集到开发者处分析。因此,如何有效地在产品代码当中添加调试日志,是影响了软件维护效率的一个重要因素。

这几篇文章主要关注的就是如何有效的写调试日志以便于分析。因为我所从事的项目主要使用C/C++进行开发,因此文章当中的介绍也主要集中在如何在C/C++的大型程序当中撰写调试日志。

文章主要关注在以下几点问题:

  • 调试日志的目的:确定调试日志设计的目标
  • 输出调试日志的方式:调试日志应该输出到哪里
  • 调试日志的分级和分类:提高日志的信噪比
  • 如何写调试日志:应该在什么地方写什么
  • 如何分析调试日志:精力应该放在刀刃上

这是第一部分,我们主要关注在前两个主题:调试日志的目的和输出调试日志的方式。

调试日志的目的和设计目标

调试日志的根本目的是为了定位错误。在这个目的下,我们才会进行更加细致的调试日志的设计。

说起定位错误,首先是这种行为的主体:谁来定位错误?首先当然是用户。我们希望,在大多数情况下,用户可以在出现错误时通过对于调试日志的简单分析即可定位错误。但是这种方法很容易让人将调试日志的作用高估:程序员希望用户会去看调试日志。事实上,调试日志对于用户的排错工作并不应作为一线工具,至少不应该用来报告系统的错误;对于系统的错误,例如用户没有给与正确的输入,或配置文件解析错误,这种需要用户去做一些行为才能让系统工作起来的消息,应该用更加直接的方式通知用户。例如在Windows上面,使用Windows事件日志(Event Log)就是一种很好的选择。但是,这条消息仍然应该记录进调试日志,以便可以记录下错误发生的细节以便于程序员进行分析。

另外一个需要分析调试日志来定位错误的就是软件维护人员。因为软件的规模问题,或者由于流程的不同,也许软件维护人员并不是本来的系统开发人员,而无论如何,对于系统的工作方式,软件维护人员都比用户了解的更多。因此如果调试日志足够好,他们可以通过调试日志,结合对于软件工作方式的理解发现更多的问题,并给出用户解决方案。因此,将调试日志写得更加易懂,说明软件“做了什么,发生了什么结果”,而不是“调用了什么函数,返回了什么值”,就能够让更加前端的软件维护人员的处理掉更多的问题,相应的,需要开发人员亲自解决的问题的数量就会减少。

最后的会去分析日志的就是软件开发人员。因此,添加必要的开发人员理解的信息也是必要的,比如函数调用参数和返回值的跟踪,条件分支的跟踪,出现错误的代码行和源文件等等,以便掌握有源代码的开发人员可以对错误的流程进行跟踪并重现。同时,由于到了开发人员手中的往往都是非常棘手的问题,往往伴随的大量的调试日志条目,因此,让调试日志的分析更容易自动化对于开发人员定位错误的帮助也是非常大的。在建立了良好的自动的调试日志分析工具之后,对于已知的问题,就可以通过工具进行快速的定位了。

综上,我们所做得对于调试日志的工作都是为了能够更容易、更早的定位错误。为了达到这个目的,我们需要能够让调试日志便于查找和搜集,便于人读取和理解,以及便于工具进行解析。

Tip 1:调试日志的设计应该以“便于定位错误”为中心目标

第一个问题就是需要调试日志便于搜集,也就是调试日志的输出问题。

输出调试日志的方式

对于调试日志应该输出到哪里,人们有很多不同的看法,在不同的环境当中也各有优劣。比较流行的几种观点是:

  1. 输出到标准输出(stdout)或标准错误(stderr)。这种一般出现在交互式命令行工具当中,使用stdio或iostream当中的库函数来书写。这种书写方式符合程序员的习惯,例如Unix的传统的工具通常使用-v(如mplayer),-debug(如openssl)或其他的选项来把细致的日志输出到stdout和stderr。这种输出的优势在于便于重定向到文件或管道。重定向的文件比较适合搜集调试日志,而使用管道比较适合实时分析。其劣势也是非常明显的:这种方式仅适用于交互式命令行工具,对于GUI程序、后台守护进程或者服务程序就不太适合了。当然对于Windows GUI程序,有一种方式可以使用CRT Output Routing,但是并不通用,而且会失去使用这种方式的根本优势,即灵活的重定向。
  2. 输出到System Debug Buffer。即通过OutputDebugStringW/A函数,或者内核态的DbgPrint(Ex)函数。这种方式并不见得有多少优势,尤其是必须通过调试器或其他工具才可以看到或dump到文件,给在用户处搜集信息造成了很大的麻烦。在我看来,使用这种方式很多时候还是不得已而为之,例如在内核态除了DbgPrint(Ex),似乎没有别的选择。但是使用调试器来搜集一些信息还是一种可以选择的方案,例如对于Windows API调用的记录,skywing在他的blog上面提供了一种在WinDbg当中可用的方法,但是仍然如我所说,在实际的用户那里,并没有太大的意义。
  3. 输出到日志文件。这种是使用的最多的方案。这种方式可以适用于除了交互式命令行工具之外的所有组件,而且非常适合用来从用户出现问题的环境当中直接收集,并由程序员进行分析。但是这种方案可能存在一些细节问题需要考虑,例如将日志文件写在哪里(临时文件目录,专用的调试日志目录,或者其他地方),文件如何命名和切分,如果调试日志量过大如何处理,写调试日志时出现错误怎么办等等。这几个问题没有固定的答案,关键在于一旦确定下来,就需要在整个软件当中保持一致。在我现在从事的项目中,我们使用的是写入到专用的调试日志目录当中,同时这个目录可以由用户通过配置文件修改;文件名使用basename.yyyymmdd.####的格式,yyyymmdd是用户本地时间的年月日,####是从1开始的编号。每个文件大小不超过某个值,一旦超过就另开一个文件。这种结构便于辅助工具寻找和收集调试日志并打包,以及在调试日志过多的时候由一个守护程序进行清理。对于写入日志的错误,建议根据当前的日志级别来处理,如果需要打出的本身就是一个严重错误的日志,最好使用某种不太容易失败的方式将日志写入其他地方,例如系统事件日志;而如果写入的只是一些信息性的或者调试
    性的消息,则可以选择忽略。

Tip 2:选用合适的日志输出方式,以便于收集和处理为目标设计。用久经考验的方案,输出到stdout/stderr或具有统一文件名格式的日志文件。

如果没有特殊的需求,对于交互式命令行工具使用直接输出到stdout/stderr,对于其他直接输出到日志文件,是调试日志输出的首选。我们当前使用的文件组织方式也可以借鉴。接下来我们就开始谈论如何能够有效的书写调试日志的内容。

标签:

Google Safe Browsing API Demo

2007年6月24日 2 条评论

今天花了一下午整出来的东西,似乎是work的,从http://www.millersmiles.co.uk/上面找了两个phishing URL,比如这个。

E:\zhangc\Documents\Works\security\SafeBrowsing\GSBDemo\Debug>GSBDemo.exe
Google Malware Hash List: version 1.117, 51242 items.
Google Black Hash List: version 1.971, 9170 items.

URL:>http://singngngdaxngggg.pochta.ru/logi22.html
This URL is unsafe because "singngngdaxngggg.pochta.ru/logi22.html" is in goog-black-hash

不过有的还不work,比如Li Fanxi给出来的那两个:

URL:>http://220.225.4.14/icons/www.paypal.com/cgi-bin/SecureInfo=_update/
This URL seems safe.

URL:>http://kallu.ch/www.PaYPaL.Com/cgi-binn/verify-account/paypal12321625615235
2132314132123/paypal-email-verification/p1_webscr-cmd-login-run.htm
This URL seems safe.

不知道是我的实现的原因还是真的就在列表当中没有。

标签:

打算做两个Firefox的扩展

2007年6月23日 没有评论

一个是为了能够在切换标签的时候自动切换输入法。因为我现在有英文、中文和日文三个输入法,经常不同的标签页当中需要输入不同的语言,因为目前Firefox似乎做不到自动记住各个标签页的配置并切换输入法,所以感到不太方便(也许是我土,有谁知道有什么方法的告诉我一声)。我期望这个东西可以这样工作:我正在写space的标签页面当中,现在是中文输入法,当我切换到别的页面的时候,或者当我按下了Ctrl+D,或者用鼠标移动到地址栏的时候,自动切换成英文输入法。一旦我在一个页面上面把输入法切换成了非英文,这个输入法就可以记录下面,下次我换到这个标签页页可以自动的切换成相应的输入法。这还是很方便的。

另一个是因为VeryCD上面的资源更新。因为我经常会追一些新的动漫,想要知道一个发布页面是不是已经更新了还是比较麻烦的——VeryCD的索引页虽然有但是毕竟经常雪崩似的出一大堆更新,然后一页放不下,可能会错过很多。后来我就把这些发布页面放在收藏夹当中,然后一个个点开看,原来数据量小的时候还好搞定,后来越来越多,麻烦的一米,加上我又很懒,考虑是不是可以在我打开Firefox的时候或者点了某个菜单项的时候直接去检查所有的这些页面有没有更新,然后自动把更新的页面打开。

研究一下Firefox的Extension,看看有没有可能。第二个想起来应该不难实现。

标签:

软件的I18N问题

2007年6月17日 2 条评论

今天读到byte写的一篇blog,记录了一下vc当中的时间表达方式,随手回复了一篇,当敲入mktime的时候,突然心中一震,有一种误人子弟的感觉,因为想到了之前一个项目当中对于时间处理的问题的切肤之痛。

当时那个问题是这样的:程序会调用time函数得到time_t(这个是GMT时间距离1970年1月1日的秒数),然后用localtime把它转换成可读的struct tm格式,即年月日时分秒的格式,然后根据它来创建文件夹,比如我现在时区是GMT+8,即北京时间,凌晨3点32分,程序就会创建一个名为20070617\0332的文件夹,然后把一些东西放在里面。过一会之后,程序会去枚举所有的文件夹然后对其中的东西进行处理,枚举的时候,程序会根据这个目录的字符串来切开做成一个struct tm格式,然后调用mktime去转换成time_t进行进一步的处理。程序会传递这个time_t,并在必要的时候重新根据它来找到文件所在的目录。简单的逻辑可以这样认为:

time_t now = time(NULL);
struct tm* tnow = localtime(now);
sprintf(szPath, "%4d%02d%02d\\%02d%02d",
tm->tm_year+1900, tm->tm_mon+1, tm->mday,
tm->tm_hour, tm->tm_min);
CreateDirectory(szPath);

// later
// find each directory to szPath, and get year, month, day, hour, min from the szPath.
// Then set struct tm dirTm;

time_t dirTime = mktime(&dirTm);
ProcessThem(dirTime);

void ProcessThem(time_t dirTime) {
struct tm* dirTm = localtime(dirTime);
szPath = getPathFromTime(dirTm);
// open the file
}

这个逻辑在中国的区域设置下面毫无问题,一切都如预想的一样运行。但是这个产品还需要被卖到美国,区域设置为太平洋标准时间的地方。那个地方有一种东西叫做夏令时,Daylight Saving Time, DST。每年的4月的第一个周日(现在已经是3月的第二个周日了,这是今年的新规定,所谓的DSTE,为此还有更多的I18N的麻烦,有机会再说),当种走到凌晨1:59:59过后,并不是正常的跳到2:00:00,而是变成3:00:00。也就是说,钟快了一个小时。到了10月的最后一个星期天(现在是11月的第一个星期天)的钟表指到1:59:59之后,钟会跳到1:00:00,也就把钟调了回来。

于是产品在进入夏令时之后出了问题,日志当中报告了大量的“找不到文件”错误。经过分析发现,在上面的逻辑当中,在夏令时切换之后,比如钟表时间3:01:00(实际上物理时间是2:01:00),第一个localtime的调用创建了一个名为20060402\0301的文件夹,之后根据这个路径初始化struct tm dirTm,但是struct tm当中的tm_idst域并没有赋值(也就是0),所以调用mktime的时候,这个函数会把struct tm结构当中的值当作非夏令时,这样转换回的time_t就指到了物理时间的3:01:00,之后再次调用localtime,获取的struct tm当中,tm_hour变成了4。这样一来,程序试图去20060402\0401下面去寻找文件,这就导致了大量的找不到文件的错误。

解决的方法有两个,一个是初始化struct tm dirTm的时候,将tm_idst设成负数,例如-1,这样mktime会根据当前时区来决定是否根据夏令时进行校对。另一种方法是完全使用GMT函数替换本地时间函数。例如localtime->gmtime,mktime->_mkgmtime。

这个问题本质上就是一个软件的I18N问题。I18N=Internationalization,即国际化,因为I和N中间有18个字符而得名,类似的还有L10N(Localization,本地化),以及G11N(Globalization,全球化)。软件的I18N问题之所以成为一个问题,是因为这个世界上有接近200个国家和地区,2000多个民族,4200多种语言,以及,地球是圆的。

应该庆幸我们生活在中国,因为中国的很多东西都很简单,尤其是牵涉到软件I18N的时候。没错,可以认为中国有世界上最大的字符集,最复杂的文字表达方式,但是我们的时区是GMT+8,没有零头,没有夏令时;中文的编码GB2312和GB18030都是上下文无关的编码,而且广泛使用的GB2312还是定长的编码(两个字节一个汉字),而且任何字节不会和7位ASCII码重叠;我们使用格列高里历法,使用公元纪年;我们的默认键盘布局是标准101键qwerty键盘;我们的文字像世界上绝大多数文字一样从左向右横向书写……所有这一切对于写软件的人来说是这是多么美好的一件事情啊。我们可以获取当前的时间,存储其年月日时分秒,将来无论什么时候拿到这个年月日时分秒,都不会有什么问题;我们可以在一个中文编码的字符串当中肆意地用strchr查找’\\’来切割文件路径,而不用担心0x5C在当前的上下文当中是表示反斜线还是日元符号(在日文编码shiftJIS当中,日元符号的编码和ASCII当中反斜线编码重叠,都是0x5C,这种问题在GB系列编码中不会存在);还有,我们的小数点就是圆点,负数就是在数字前面加上负号,而不是用逗号表示小数点(德文地区是这样的),而且不会用括号表示负数(欧洲某地如此,不记得哪国了)。

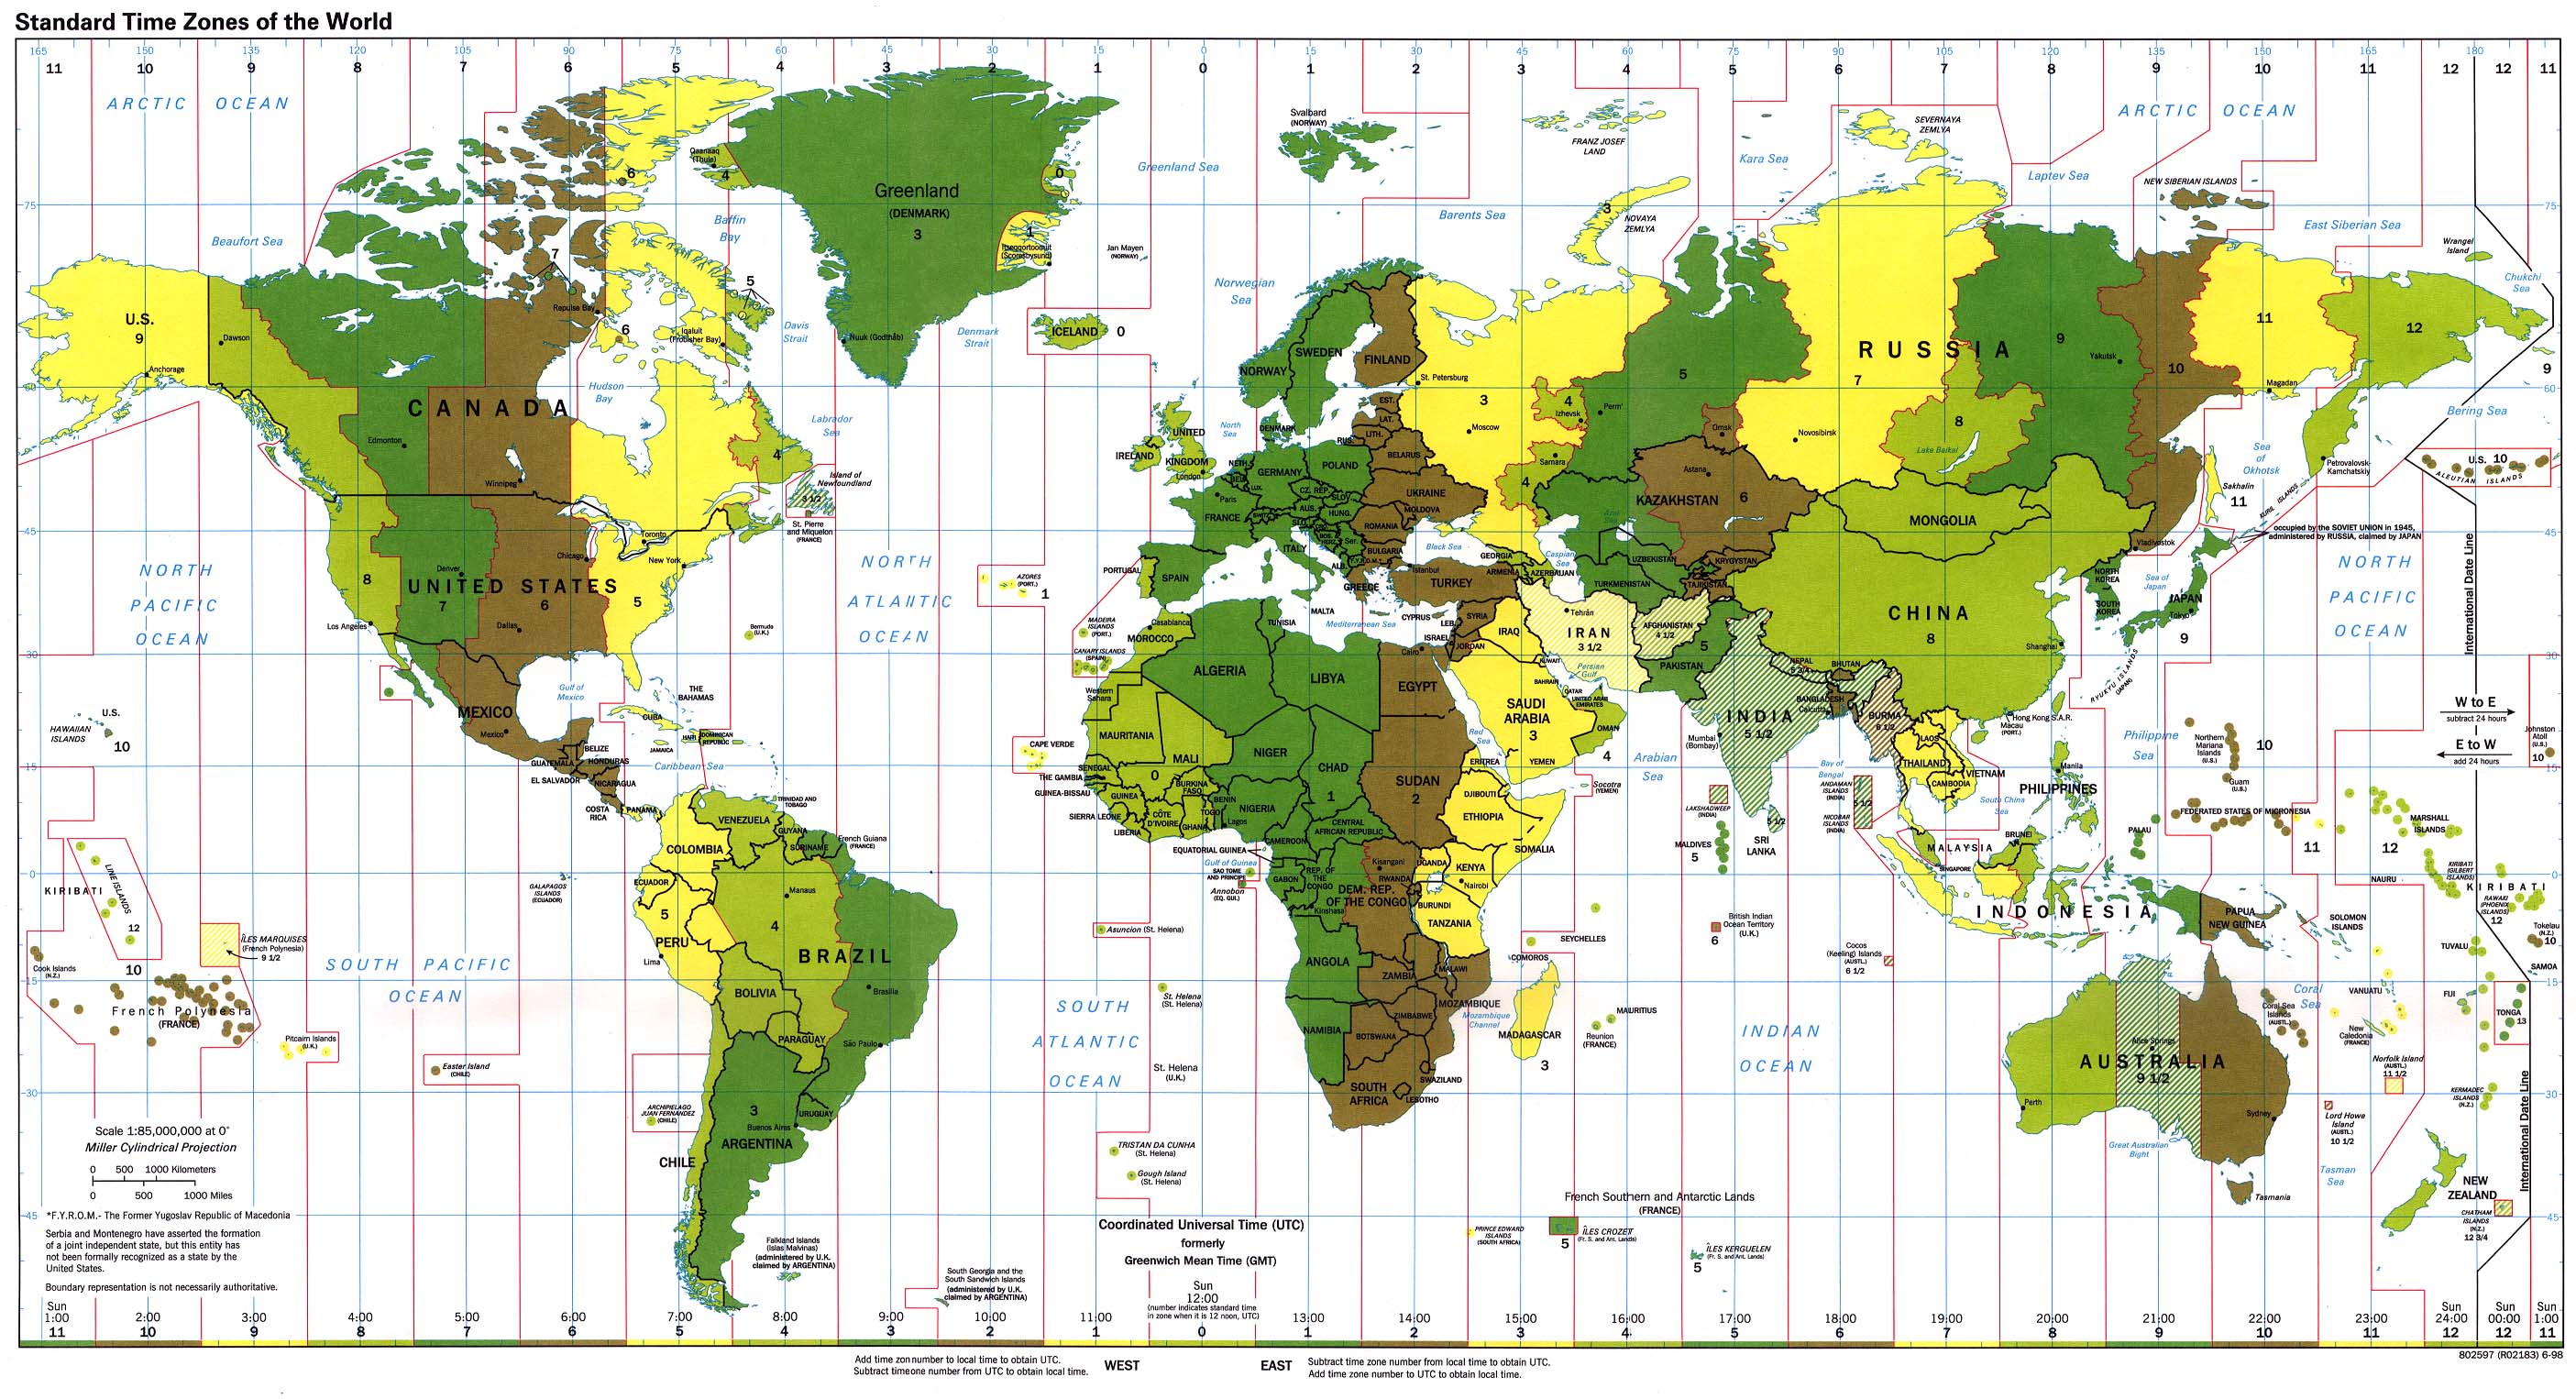
但是这样也会让我们中国的软件工程师低估了软件I18N的难度:不是所有国家的人们的时间都是连续的,很多国家在使用夏令时;很多国家或地区不使用公元纪年,比如日本和台湾;还有些地方不使用格列高里历法,例如中东的很多国家。说起时间,时区也不一定总是东八区,西五区这么简单。印度大部分地区都是GMT+5.5,尼泊尔是GMT+5.75;太平洋上某岛国(TONGA)是GMT+13,这是全球最早的时间;中东某小国由于宗教原因时区是GMT-89,也许是全球最晚的时间了。可以看看这张全球时区划分图来看看有多少诡异的时区吧(这张图有些老,98年的,所以很多诡异的都还没有,不过已经够多了)。

而谈及语言编码,那又有了更多的问题,现在太晚了,有空再写。

标签:

侯捷的Design Patterns培训杂感(续)

2007年6月1日 2 条评论

昨天连同今天,仍然继续培训,每天从下午两点到晚上八点。昨天主要讲Pool Allocation(这个东西权且算是一个Pattern吧,但是我觉得算不上Design Pattern),今天下午仍然是Pool Allocation。到了晚上主要是Command模式。

Pool Allocation这个东西我觉得没有什么太值得研究的,今天讲的一些比较出名的实现(Loki,SGI STL和boost)所用的算法都很简单且有效,基本上一个可用的pool就是这样写出来的。本来这种内存当中的pool一般不太在意尽可能减少随机访问,但是前些天工作需要写过一个基于文件的pool,用来管理流过MTA的所有邮件或者HTTP Proxy的所有content,因为需要把他们存下来扫描。基于文件的原因是我们必须保持这个信息在程序crash之后的可恢复性。这个pool对于随机访问就很敏感了,这种东西的算法,也许可以总结一下。

其实这三天最大的收获在于,N本书拿过去签名,然后还有最后的一张合影。

标签:

侯捷的Design Patterns培训杂感

2007年5月30日 没有评论

应该是公司花了不少钱请来的,虽然据他说他和趋势一直保持着良好的关系。

今天第一天,后面还有两天,题目关于Design Patterns。第一天总体感觉不错,jjhou确实是一个文字的高手,也可能是看得多了,翻得多了,写得多了,讲得多了也就自然成了高手。旧的东西从新的人口中讲出来,往往可以有更多的认识。

今天主要讲的是一些比较简单的OO概念和几个简单的模式,讲模式从Template Method开始,引出重用的基石:延迟实现;然后从其不足引出Strategy,然后解释OO当中的delegation。这个门入的非常cool。我们也在做Design Patterns的讨论班,从Factory模式开始,结果发现非常难于入门——不太熟悉的人都在问:为什么我们要用Factory来创建对象?今天发现,结构型模式,尤其是Template Method确实是一个不错的切入点。而且jjhou也说,Factory一定程度上也是由于Template Method产生的——当算法骨架当中需要创建object的时候。

然后是Adapter。本来我一直认为Adapter非常的简单,因而从来没有深入的考虑过Adapter更深层的东西。今天jjhou的例子却让我打开了一个新看待Adapter的视角:STL的functor adapter(事后查了一下《STL源码剖析》,发现其中有讲)。其实interface不一定是纯虚基类,std::unary_function也是一种interface,考虑template meta programming,当中的typedef也是一种interface!cool。原来adapter真的无处不在。

吃过晚饭一直在讲Reference Counting,传说中的来自于More Effective C++。这本书在大二的时候浏览过一番,后来就再也没有重读(那个时候还不知道什么是Design Patterns)。现在回头再去读一下,发现确实有一些不同的收获。一个Reference Counting的东西讲了这么久是因为例子。例子应该还是来自于他的《STL源码剖析》,源于SGI STL(古老的用于写书的那个版本)当中的string实现,中间穿插有copy on write。整个讲述的过程当中思路非常好,如果思路跟的上(其实以他讲的速度基本上都可以跟得上),听起来的确有趣,和他的书一个风格,从故事开头娓娓道来,深入浅出。不过我一直在考虑这个东西用在string上面的意义。Reference Counting用在string上面的最大问题在于非透明性——尤其对于遗留下来的代码的复用:试想一个用C实现的程序需要一个char*指针,如果这个时候传入了一个用Reference Counting实现的string.c_str()得到的东西,那么十有八九会出现问题。遗留下来的C程序并不知道这个东西是不是被share了,或者他的Reference Counting是多少。有人说“你不用c代码不就行了”,没错,非常好,但是在大型项目当中几乎做不到:大型项目有很多遗留代码和无法控制的第三方库,你可以在重写和复用之间权衡,但是一旦选择了复用,想要不出问题,概率大概和南京一整天不出现车祸的几率差不多(大概<0.1%)。所以VC8的std::string已经彻底抛弃掉了Reference Counting,大概也就是因为Windows平台上如此多的遗留程序和软件造成的。

但是string的Reference Counting的问题不足以掩盖Reference Counting的价值。但是一个好的Reference Counting的代码太难写了,尤其是要保证线程安全的时候(比如CComObjectRoot和CComMultiThreadedModel)。感觉还是非侵入式的Reference Counting比较安全一点,例如shared_ptr,这个应该明天会讲。

仔细想想为什么Reference Counting + Copy on Write这么难搞定,直接原因是因为现实和理想之间的差距:因为c风格的字符串处理函数无处不在——虽然guru们建议我们不要用它们,但是那之前的历史更长。而c风格的字符串处理函数有一个假设,即字符串的二进制布局:以单字节零结尾的连续内存空间。但是string没有这个假设。至于这种对于二进制布局的放弃,确实增加了string的灵活性,但同时也增加了互操作性的难度。我感觉在现在的环境当中来看,在C++程序员对于“用const引用替换传值调用”已成为一种思维定势,并且编译器有了更强的优化能力的情况下,在string上面使用Reference Counting真的是弊大于利。Reference Counting解决的是减少复制string对象的内存分配开销,而一旦使用了Reference Counting,为了保持string的行为,修改两个共享存储的string对象当中的任何一个都必须使用Copy-on-Write。但是,当C++程序员复制一个string对象的时候,他的目的在绝大多数时候都是为了修改它(我相信对于大多数有经验的C++程序员来说,这个命题基本成立),如果这个假设成立的话,Reference Counting的作用其实并不太大。不过仍然存在着其他的可能性,例如作为类成员的string object。不过我认为这种东西不应该会是性能的瓶颈:如果人们需要频繁的拷贝一个具有string成员变量的类实例,这种设计往往就有问题,有经验的C++程序员应该会避免的。剩下的能够从string的Reference Counting当中得利的,也就是很少的一部分case了。这种时候去寻找一个用Reference Counting实现的专用版本的string,看起来似乎更加合理。

在我看来,C++从一开始就放弃对二进制和线程模型的标准化也许是一个错误(虽然这样确实让C++可以在更多的平台上发挥作用)。因为没有二进制和线程模型,C++才不得不在编译期做文章,于是才有了模板元编程和很多的编译期优化手段。但是对于强调运行期的可配制性的产品,编译期的手段很难有用武之地。这种环境当中,更加动态的,可以在运行期变化的方案更受欢迎。这么来看,介于编译型语言和脚本语言之间的方案会很有前途,比如.NET的IL+JIT。

标签: