Python multiprocessing 使用手记[2] – 跨进程对象共享

2009年12月7日 没有评论

继续写关于Python multiprocessing的使用手记,继上次的进程模型之后,这次展开讨论一下multiprocessing当中的跨进程对象共享的问题。

在mp库当中,跨进程对象共享有三种方式,第一种仅适用于原生机器类型,即python.ctypes当中的类型,这种在mp库的文档当中称为shared memory方式,即通过共享内存共享对象;另外一种称之为server process,即有一个服务器进程负责维护所有的对象,而其他进程连接到该进程,通过代理对象操作服务器进程当中的对象;最后一种在mp文档当中没有单独提出,但是在其中多次提到,而且是mp库当中最重要的一种共享方式,称为inheritance,即继承,对象在父进程当中创建,然后在父进程是通过multiprocessing.Process创建子进程之后,子进程自动继承了父进程当中的对象,并且子进程对这些对象的操作都是反映到了同一个对象。

这三者共享方式各有特色,在这里进行一些简单的比较。

首先是共享方式所应对的对象类型,看这个表:

共享方式 支持的类型
Shared memory ctypes当中的类型,通过RawValue,RawArray等包装类提供
Inheritance 系统内核对象,以及基于这些对象实现的对象。包括Pipe, Queue, JoinableQueue, 同步对象(Semaphore, Lock, RLock, Condition, Event等等)
Server process 所有对象,可能需要自己手工提供代理对象(Proxy)

这个表总结了三种不同的共享方式所支持的类型,下面一个个展开讨论。

其中最单纯简单的就是shared memory这种方式,只有ctypes当中的数据类型可以通过这种方式共享。由于mp库本身缺少命名的机制,即在一个进程当中创建的对象,无法在另外一个进程当中通过名字来引用,因此,这种共享方式依赖于继承,对象应该由父进程创建,然后由子进程引用。关于这种机制的例子,可以参见Python文档当中的例子 Synchronization types like locks, conditions and queues,参考其中的test_sharedvalues函数。

然后是继承方式。首先关于继承方式需要有说明,继承本质上并不是一种对象共享的机制,对象共享只是其副作用。子进程从父进程继承来的对象并不一定是共享的。继承本质上是父进程fork出的子进程自动继承父进程的内存状态和对象描述符。因此,实际上子进程复制了一份父进程的对象,只不过,当这个对象包装了一些系统内核对象的描述符的时候,拷贝这个对象(及其包装的描述符)实现了对象的共享。因此,在上面的表当中,只有系统内核对象,和基于这些对象实现的对象,才能够通过继承来共享。通过继承共享的对象在linux平台上没有任何限制,但是在Windows上面由于没有fork的实现,因此有一些额外的限制条件,因此,在Windows上面,继承方式是几乎无法用的。

最后就是Server Process这种方式。这种方式可以支持的类型比另外两种都多,因为其模型是这样的:
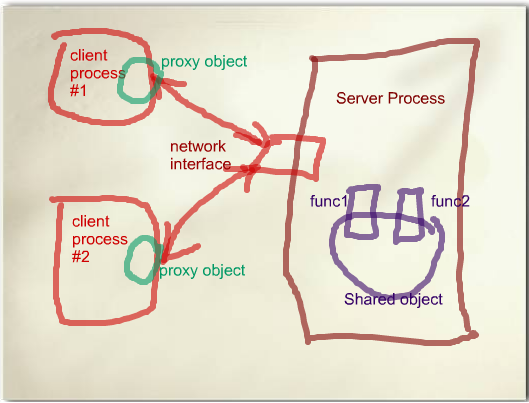
server process模型

server process模型

在这个模型当中,有一个manager进程,负责管理实际的对象。真正的对象也是在manager进程的内存空间当中。所有需要访问该对象的进程都需要先连接到该管理进程,然后获取到对象的一个代理对象(Proxy object),通常情况下,这个代理对象提供了实际对象的公共函数的代理,将函数参数进行pickle,然后通过连接传送到管理进程当中,管理进程将参数unpickle之后,转发给相应的实际对象的函数,返回值(或者异常)同样经过管理进程pickle之后,通过连接传回到客户进程,再由proxy对象进行unpickle,返回给调用者或者抛出异常。

很明显,这个模型是一个典型的RPC(远程过程调用)的模型。因为每个客户进程实际上都是在访问manager进程当中的对象,因此完全可以通过这个实现对象共享。

manager和proxy之间的连接可以是基于socket的网络连接,也可以是unix pipe。如果是使用基于socket的连接方式,在使用proxy之前,需要调用manager对象的connect函数与远程的manager进程建立连接。由于manager进程会打开端口接收该连接,因此必要的身份验证是需要的,否则任何人都可以连上manager弄乱你的共享对象。mp库通过authkey的方式来进行身份验证。

在实现当中,manager进程通过multiprocessing.Manager类或者BaseManager的子类实现。BaseManager提供了函数register注册一个函数来获取共享对象的proxy。这个函数会被客户进程调用,然后在manager进程当中执行。这个函数可以返回一个共享的对象(对所有的调用返回同一个对象),或者可以为每一个调用创建一个新的对象,通过前者就可以实现多个进程共享一个对象。关于这个的用法可以参考Python文档当中的例子“Demonstration of how to create and use customized managers and proxies”。

典型的导出一个共享对象的代码是:

ObjectType object_
class ObjectManager(multiprocessing.managers.BaseManager): pass
ObjectManager.register("object", lambda: object_)

注意上面介绍proxy对象的时候,我提到的“公共函数”四个字。每个proxy对象只会导出实际对象的公共函数。这里面有两个含义,一个是“公共”,即所有非下划线开头的成员,另一个是“函数”,即所有callable的成员。这就带来一些限制,一是无法导出属性,二是无法导出一些公共的特殊函数,例如__get__, __next__等等。对于这个mp库有一套处理,即自定义proxy对象。首先是BaseManager的register可以提供一个proxy_type作为第三个参数,这个参数指定了哪些成员需要被导出。详细的使用方法可以参见文档当中的第一个例子。

另外manager还有一些细节的问题需要注意。由于Proxy对象不是线程安全的,因此如果需要在一个多线程程序当中使用proxy,mp库会为每个线程创建一个proxy对象,而每个proxy对象都会对server process创建一个连接,而manager那边对于每个连接都创建一个单独的线程来为其服务。这样带来的问题就是,如果客户进程有很多线程,很容易会导致manager进程的fd数目达到ulimit的限制,即使没有达到限制,也会因为manager进程当中有太多线程而严重影响manager的性能。解决方案可以是一个进程内cache,只有一个单独的线程可以创建proxy对象访问共享对象,其余线程只能访问该进程当中的cache。

一旦manager因为达到ulimit限制或者其他异常,manager会直接退出,遗憾的是,这时候已经建立的proxy会试图重新连接manager – 但是它已经不存在了。这个会导致客户进程hang在对proxy的函数调用上,这个时候,目前除了杀掉进程没有找到别的办法。

另外proxy使用socket的方式比较tricky,因此和内置的socket库有很多冲突,比如socket.setdefaulttimeout(Python Issue 6056 )。在setdefaulttimeout调用了之后,进程当中所有通过socket模块建立的socket都是被设置为unblock模式的,但是mp库并不知道这一点,而且它总是假设socket都是block模式的,于是,一旦调用了setdefaulttimeout,所有对于proxy的函数调用都会抛出OSError,错误代码为11,错误原因是非常有误导性的“Resource temporarily unavailable”,实际上就是EAGAIN。这个错误可以通过我提供的一个patch来补救(这个patch当中还包含其他的一些修复,所以请自行查看并修改该patch)。

由于以上的一些原因,server process模式作为一个对象的共享模式,能够提供最为灵活的共享方式,但是也有最多的问题。这个在使用过程当中就靠自己去衡量了。目前我们的系统对于数据可靠性方面要求不高,丢失数据是可以接受的,但是也只用这种模式来维护统计值,不敢用来维护更多的东西。

关于跨进程共享对象的问题就写到这里,后面内容待续……

test_sharedvalues

OpenInkpot 0.2正式版发布

2009年12月6日 没有评论

OpenInkpot的负责人dottedmag刚刚在OpenInkpot的官方用户列表当中宣布了OpenInkpot 0.2的发布。这个历时一年的版本终于发布了。从0.2版本开始做我就基本上在参与Wiki的中文化和界面的中文化,如果有任何关于中文翻译的问题,可以通过 @ftofficer, ftofficer@ftofficer.com联系到我。

0.2之后,马上就要开始0.3的开发。根据之前的计划,0.3将会在PDF的处理性能,更多的设备支持,更多的格式和应用软件方向发展。

下面是dottedmag的宣布邮件的翻译:

我们骄傲的宣布OpenInkpot 0.2的发布。OpenInkpot是为电子书阅读器和电子纸屏幕设备设计的自由和开源的固件。

在开发当中(相比于0.1)几乎所有的代码都被重写了,因此不可能提供一个完整的更新列表。值得注意的更新包括:

设备支持

  • 新支持汉王N510和汉王N516

功能

  • PDF 和 Djvu 阅读器
  • 简单的图像查看器
  • 简单的音乐播放器(仅为汉王N510和N516提供)

界面

  • 14种语言的新界面
  • Azbooka提供的新的界面观感
  • 屏幕旋转
  • 屏幕锁定
  • 低电量警告

其他

  • 添加了大量的新的益智游戏

文档

OpenInkpot 0.2 可以在这里下载

http://openinkpot.org/pub/releases/0.2/

— 米哈伊尔 古萨罗夫,代表OpenInkpot项目组。

标签: ,

招商银行专业版的几个问题和解决方案

2009年11月23日 1 条评论

用招行专业版有一段时间了,其间遇到的问题无数,而且每个问题都让我这个计算机专业人员极其困扰,客服电话也打了无数,每个平均半个小时,大多数问题都是在客服的启发下自己一个个尝试出来的,希望直接一个客服电话搞定也不太可能。

好在大多数问题都是兼容性问题,因为招行专业版本质上就是一个IE的壳,因此IE的版本和配置对于招行专业版有很大的影响。而且和国内的其他银行一样,为了保证密码的安全性,招行专业版使用了ActiveX控件来处理密码输入,这个ActiveX甚至会直接操作键盘驱动,因此,和其他软件常有冲突。这些问题大部分可以通过修改IE配置的方法绕过。考虑到未来有人会遇到类似的问题,整理一下放在这里吧。

明明网络已经连接,但是登录的时候还是报“通讯错误”,或者“xxxx不是有效的日期”之类的诡异问题

这个通常出现在安装了IE8的机器上,因为专业版貌似用了很多山寨的方式来包装IE,导致IE升级到IE8之后有众多冲突,两个冲突的大头是IE8的内存保护(DEP)和https证书验证。

首先是内存保护(DEP),这是个很有用的功能,可以极大增强计算机的安全性,防止很多导致中毒的恶意网页,但是偏偏和专业版有冲突,所以,使用专业版的时候,临时禁用它吧。方法是在IE的Internet选项当中的高级下面,将“启用内存保护减少联机攻击”前面的勾去掉。

另一个就是https证书验证。IE8开始检查证书吊销列表,这样可以保护用户免受一些被泄露的https证书的伤害。同样专业版和它冲突,(并不是说专业版的证书泄露了,只是功能不兼容)。方法是在IE的Internet选项的高级下面,将“检查服务器证书吊销”前面的勾去掉。

在转账、汇款等需要输入密码的地方,遇到“通讯环境内存操作失败”

这个很可能是和机器上其他的密码控件的冲突,例如QQ的登录框当中的控件,360保险箱等等。正常情况下关闭QQ,禁用保险箱再重新登录即可。

-2009年11月30日更新-
今天升级了360安全卫士之后发现又不能用了,发现是专业版和360安全卫士的主动防御模块冲突。暂时关闭360安全卫士(同时会禁用主动防御)就可以了。

其它问题,持续整理中。

标签: ,

Python multiprocessing 使用手记[1] – 进程模型

2009年11月10日 没有评论

首先从multiprocessing的进程模型开始看。

multiprocessing的目的是创建一个接口和python.threading类似接口的库,用多进程的方式来并发处理。因此创建一个新的进程的的方法也和python.threading很像:

import multiprocessing
 
def dosomething(a,b,c): pass
 
p = multiprocessing.Process(target=dosomething, args=(1,2,3))
p.start()
p.join()

创建的这个新的进程在*nix上面使用的是fork,这意味着子进程开始执行的时候具有与父进程相同的全部内容。请记住这点,这个将是下面我们讨论基于继承的对象共享的基础。所谓基于继承的对象共享,是说在创建子进程之前由父进程初始化的某些对象可以在子进程当中直接访问到。在Windows平台上,因为没有fork语义的系统调用,基于继承的共享对象比*nix有更多的限制,最主要就是体现在要求Process的__init__当中的参数必须可以Pickle。

但是,并不是所有的对象都是可以通过继承来共享,只有multiprocessing库当中的某些对象才可以。例如Queue,同步对象,共享变量,Manager等等。

在一个multiprocessing库的典型使用场景下,所有的子进程都是由一个父进程启动起来的,这个父进程称为master进程。这个父进程非常重要,它会管理一系列的对象状态,一旦这个进程退出,子进程很可能会处于一个很不稳定的状态,因为它们共享的状态也许已经被损坏掉了。因此,这个进程最好尽可能做最少的事情,以便保持其稳定性。

Python multiprocessing库使用手记(引子)

2009年11月9日 2 条评论

前段时间在做的一个Python项目,需要实现一个后台服务程序,程序流程比较复杂,而且可能经常变动,但是如果把整个流程切分成一些步骤,每个步骤有自己的输入输出和处理。只要将他们的输入输出接在一起,进行不同的组合就可以实现常见的流程变动。

使用多进程的原因是考虑到Python的全局解释器锁(Global Interceptor Lock, GIL)。由于GIL的存在,在CPU密集型的程序当中,使用多线程并不能有效地利用多核CPU的优势,因为一个解释器在同一时刻只会有一个线程在执行。要想尽可能利用多核CPU并发,多进程是必需的。

引入多进程就带来几个问题:首先是这种设计方案需要一个类似于UNIX Pipe的底层结构,说的更确切一点就是message queue,操作类似于Python的Queue.Queue。另一个问题就是需要一个进程间信息共享的基础设施。

先说Queue,这个Queue需要满足下面一些需求,优先级递减:

  • 轻量 – 不需要依赖数据库等比较重型的程序。代价就是丢点东西没关系;
  • 跨进程 – 读端和写端可以不在一个进程当中;
  • 支持多进多出 – 读端和写端都要支持多个进程;
  • 稳定和高效 – 这个就不用多说了吧;
  • 有Python的API,再不济要有C的API可以让我写Python的binding。

另外是进程间共享的设施,系统shm是迫不得已使用的,因为要自己处理Pickling和Unpickling,以及一些杂七杂八的竞争条件问题。有建构在上面的现成的库最好。

最终出于轻量的考虑,选定了Python的multiprocessing库,而没有用IPC MQ 或 RabbitMQ。这个库在Python2.6被引入到标准库当中,有为2.5提供的backport。因为我们的系统使用的是2.5版本,因此我们使用的其实是2.5的backport。这个实现除了一些细枝末节的地方之外,核心实现和2.6标准库当中是完全一样的。

在使用过程当中,遇到了挺多的问题,在这里一一记录。

OpenInkpot 0.2 中文化进度

2009年10月4日 没有评论

最近OpenInkpot已经发布了官方0.2预发布版本20091001(算是给国庆献礼么?:P),这个版本第一次把中文本地化的内容包含在内,也就是说将来大家使用OpenInkpot的时候就可以看到中文的界面了。大家可以在首次刷机之后选择语言为“简体中文”,或者到设置/Setup里面更改。注意选择语言界面里面9,0两个键不能用来翻页的,小心选中了希腊语。:P

目前中文化的部分仍然在进行当中,已经完成的部分包括:

1. 新的中文字体,使用文泉驿中文字体替换掉了以前的老字体,中文显示漂亮了很多。
2. Wiki页面的中文化,包括用户手册(http://openinkpot.org/wiki/0.2/UsersGuide/zh)和安装指南(http://openinkpot.org/wiki/0.2/InstallationGuide/zh)。
3. 大部分程序界面的中文化。包括书架、非PDF阅读器的大部分。PDF阅读器(LocoPDF)当中的字符串现在还没有抽出来,因此暂时还只有英文界面。中文化进度可以到http://l10n.openinkpot.org查看,有兴趣的也可以注册上去参与翻译和查看翻译进度。

正在进行的工作包括:
1. 随机帮助文档的翻译。这个功能在最近才刚刚加入到OI当中,翻译工作也刚刚开始进行。有兴趣的可以参见http://groups.google.com/group/openinkpot-l10n/browse_thread/thread/ac83e60784869903
2. 应用程序名的翻译。现在还没有好的名字想出来,因此暂时没有提交。征求大家的意见,下面这些应用程序名怎么翻译比较合适:

* FBReader: 默认的非PDF阅读器
* CoolReader: 可选的非PDF阅读器
* LocoPDF: 默认的PDF阅读器
* MadEye: 默认的图片查看器
* 小游戏们:Bridges Puzzle, Fifteen Puzzle, Flip Puzzle, Pegs Puzzle, Solo (Suduko like) Puzzle, Twiddle Puzzle。都是一些益智小游戏,介绍可以参见http://www.chiark.greenend.org.uk/~sgtatham/puzzles/

3. 一些杂七杂八的东西,例如存储器名字,“Internal Storage”和”SD Card”这种,还没翻译。

如果有什么本地化相关的建议,可以直接联系我 (ftofficer@ftofficer.com)

标签:

Follow up: 可用于OpenInkpot的Trac扩展:TranslatedPages

2009年1月26日 2 条评论

继续上一篇当中提到的扩展。

http://trac-hacks.org/wiki/TranslatedPagesMacro

扩展目前实现成Macro的形式,但是硬编码了支持的语言类型,很丑。

下一步继续扩展,需要提供一个Web UI来管理需要支持的语言列表,然后还要加上权限控制,估计要写成Plugin了。

Firefox 当中HTML控件无法正常显示

2008年10月3日 没有评论

今天照常上网的时候,突然发现自己的Google主页上面的所有按钮上面的文字都消失了,所有的单选按钮也都消失了。
变成了这样:

Firefox Render HTML Control Bug

这个问题最后得以解决,解决方案如下:
首先,在地址栏输入about:config,然后找到nglayout.debug.enable_xbl_forms这个配置项,如果它是true的话,把它改成false。重新启动Firefox即可。

======我是无聊的分割线======

如果你的兴趣仅限于解决这个问题,下面的查错过程请无视。

这当然是非常不爽的一件事情,于是我开始回忆在上次显示尚且完好之后我做了什么操作,但是实在想不起来上次完好是什么时候的事情了——我上网一般都是在Google Reader上面徘徊,而Google Reader上面确实没有什么显眼的HTML标准控件可以让我发现这个问题。

于是没有办法,只好开始手动排错。在重新启动Firefox,重新启动Windows,用IE访问Google主页三步之后,基本可以排除系统原因或者Google的网页本身的原因。接下来看看是不是插件的问题,那么就先从“安全模式”开始看看问题是否能够解决。于是打开Firefox在开始菜单当中的安全模式,然后把“禁用所有扩展”打勾,重新访问Google,问题依旧,因此也不是插件的问题。那么是Firefox本身程序的问题么?为了考察这个,我新建一个Profile:在命令行中输入<path_to_firefox>\firefox.exe -P,注意P需要大写,然后再弹出对话框当中选择新建配置文件之类,完成之后用这个新的配置文件启动,然后访问Google,没有问题。因此看起来问题仍然在Profile本身。

Profile当中既然不是插件的问题,那么很可能就是首选项的问题了。我们知道在每个Profile目录下面有一个prefs.js的文件,是Firefox在当前情况下的所有的首选项的值,也就是在about:config里面看到的东西。最简单的就是比较两个Profile当中的prefs.js文件。在经过了大约半个小时,尝试过数十个不同的首选项之后,发现了nglayout.debug.enable_xbl_forms这个罪魁祸首。

然后用这个key的名字来搜索,发现其实这个是从Mozilla 1.3就开始有的问题,最早可以追溯到2002年12月:

XBL-based form controls are broken and
unusable in 1.3 and trunk builds.
(bug 185612)
If HTML form controls are not appearing and functioning on HTML pages,
check ‘prefs.js’ for the line ‘user_pref("nglayout.debug.enable_xbl_forms", true);’.
NOTE: this will only affect you if you had previously set this preference
in the ‘Debug’ panel in a previous build of mozilla. Casual users should
never change any of these settings.

这个至今未关的Bug (185612)就是在讨论我遇到的这个问题。

事情还没有结束。

在我没有修改这个键值的情况下,是谁动了我的Firefox键值?

在仔细回顾了这个问题之前一天我所做的事情之后,发现嫌疑最大的是插件 XPCOMViewer 版本0.9a。在新建的Profile上面尝试,发现一旦打开XPCOMViewer的主窗口,这个键立即就被改变成了true。也许是作者为了绕过某个难解的bug吧。之后查阅XPCOMViewer网站,发现作者公布的最新开发版1.0a当中已经修复了这个问题,也许我应该给作者发一封信告诉他应该更新一下Mozilla网站上面的版本了。

最后要澄清一下,虽然0.9a有这样的问题,但是作为一个仍然在sandbox当中的项目,这个扩展已经做得相当的好用。根据作者最近的一篇文章当中所说,1.0a版本支持一个非常cool的特性:直接将一个XPCOM组件导出成为Javascript/C++/Python的代码。对于有意在Firefox平台上面做点事情的朋友,这个扩展值得推荐。

标签: ,

TabIMSwitch 成为Mozilla Addons网站上的正式插件!

2008年9月27日 1 条评论

昨天收到了Mozilla Addons发来的邮件,经过漫长的等待,TabIMSwitch已经成为了Mozilla Addons大家庭的正式一员。
现在你可以登录Mozilla Addons上的页面来下载最新版本了。

https://addons.mozilla.org/addon/5413

—
5413将是你的终生代号 :b

说说一个新的老概念coroutine

2008年8月18日 4 条评论

因为最近的工作当中频繁地用到了异步的IO编程模型,对于异步模型的难于维护性深感切肤之痛。工作之余便在考虑有没有什么方法可以使这种模型变得更加的易读易写和易维护,有一个想法很自然的产生了,就是用我们熟悉的流程化的方法来做写处理流程,然后在一些IO触发点上异步化,也就是触发一个异步IO请求,将当前的执行状态换出,换入另一个执行状态,直到IO请求结束,该执行状态被再次换入,则继续执行。

后来去搜索相关的问题,发现其实这个是一个很老的想法了。在计算机科学当中,这个术语叫做Coroutine,最早提出是在1969年,而在早期的高级语言lisp和schema当中就有实现。如果把Coroutine和函数进行比较的话,函数只有一个入口点,而Coroutine可以有多个入口点。当Coroutine被第一次调用到的时候,它将从起始处开始执行,一旦遇到具有yield语义的语句的时候,就是返回给另外一个Coroutine或者调用者,而在接下来被调用的时候,就从yield语句下面的一条语句继续执行直到遇到新的yield语句或者Coroutine的结束。

如果了解Python,其实Python当中的Generator就是一种Coroutine。比如

def xrange(start, end):
    val = start;
    while ( val < start ):
       yield val
       val += 1

除了Python,Stackless-Python和.NET也有相应的实现,而C/C++虽然有一些实现,但是通用性都不太好,因为实现难度相对比较大,毕竟Coroutine完全颠覆了C/C++基于stack的函数调用模型。

下面大体上看一下Coroutine的几个C实现,下次再写。

标签: ,